别让缓存白花钱——仙踪问道·爱马仕助手 0.4 版上线Token节约档位
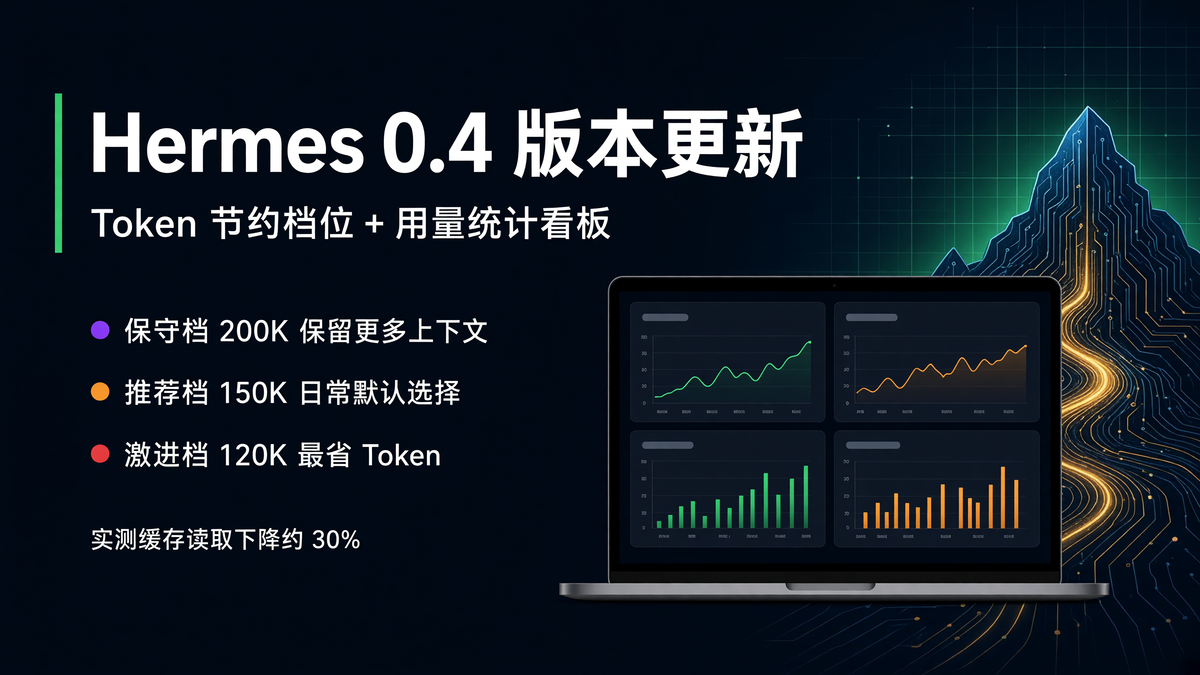
Hermes 助手 0.4 版上线两组功能:节约档位分 200K、150K、120K 三档可选,实测单周缓存读取从 576M 降到 399M,降幅约三成;近 7 天用量看板把会话数、API 调用、缓存读取、压缩次数摊开给你看,讲清三档怎么选、看板怎么读、切换要注意什么,老用户升级后即可上手。
有用户问过同一个问题:模型没换、问题没变、用法也差不多,为什么这个月的 AI 账单比上个月多了一截?查下来的答案有点意外——问题不在你问得多,而在一个本该自动触发的开关上,它几乎从没被触发过。Hermes 助手 0.4 版要修的就是这件事。
压缩为什么一直没开工
上下文压缩的触发点按比例算。Hermes 的默认阈值是 0.50,意思是上下文用到窗口容量的一半,压缩才会启动。这个设定放在 128K 窗口上没问题,用到 64K 就压;换成 1M 窗口,得先攒够 50 万 token 才轮得到它。日常对话很难堆到这个量,压缩这一步就长期空转。
空转的代价藏在缓存里。每一轮对话,助手都要把当前上下文重新发一遍,其中大部分是能命中缓存的重复内容。缓存读取的单价确实便宜,可它会被反复读取,轮次越多,重复搬运的量越大——就像洗衣机的水位档一直挂在整桶,你只洗两件衬衫,水费还是按一整桶算。
省钱的杠杆不在折扣大小,而在重复的次数。
新功能一:三档节约档位,点一下就能切
入口在 Hermes 管理 → 运行状态 卡片的右上角,点那个 ⚡ 图标就能选。三档调的其实是同一个参数:压缩触发点的固定上限,配置项叫 compression.threshold_tokens。官方文档写得很清楚,这个值默认等于阈值比例乘以模型上下文长度,窗口越大算出来越高,压缩就越等不到;钉一个固定上限,等于把这个放大效应掐掉。
档位 | 触发点 | 适合谁 | 效果 |
|---|---|---|---|
🛡️ 保守 | 200K | 常处理长文档、复杂任务 | 保留更多上下文,节省幅度温和 |
⚡ 推荐 | 150K | 日常使用,多数人的默认 | 节省与质量平衡 |
📉 激进 | 120K | 追求更大节省幅度 | 更省 token,超长任务可能忘记早期细节 |
怎么选,看任务类型就行:长文档、复杂任务用保守档,日常写方案改稿用推荐档,短任务密集、轮次多的场景用激进档。代价说在前面,激进档在超长任务里可能丢掉较早的细节——省 token 和保留上下文,本来就是一回事的两面。
仙踪问道团队自己长期用推荐档。把触发点从默认值钉到 150K 之后,同一个账号、同样的使用节奏跑了一周,缓存读取量从 576M 降到 399M,少了 177M,降幅约三成;换算一下,这一周里少重复搬运了接近 1.8 亿个 token 的上下文。
新功能二:用量看板
运行状态卡片下面新增了近 7 天用量看板,数据只读本地会话数据库,不上传也不外发。表头显示当前触发点,例如「触发点: 150.0K」,底部是输入、输出的分项总量,右上角还有一个手动刷新按钮,刚跑完一次长任务可以立刻看变化。
指标 | 含义 | 示例值 |
|---|---|---|
会话数 | 这段时间开了多少段对话 | 156 |
API 调用 | 一共向模型发了多少次请求 | 5.3K |
缓存读取 | 重复上下文被读取的总量,账单主力 | 691.3M |
压缩次数 | 触发点被踩到几次,反映档位是否合适 | 43 |
这块看板重点看两个数字的配合。缓存读取很大、压缩次数却长期停在个位数,说明触发点定高了,压缩基本没在干活,可以往激进档挪一格;反过来,压缩次数很频繁、长任务又总丢上下文,就往保守档退一格。仙踪问道提醒,档位不是设一次就不动的开关,跟着任务类型调整才有意义。
切换前要知道的四件事
这次更新不涉及数据迁移,老用户升级后直接可见,不用改配置文件,也不用重新安装。有四件事提前说清楚,省得切换的时候犹豫。
- 档位调整即时保存,压缩策略对新会话生效,正在跑的会话不会被中途打断。
- 部分限制项需要重启 Hermes 服务后生效,保存时界面会有提示。
- 已有会话不受影响,随时可以来回切换,历史对话不会被改写。
- 每次切换前,系统会自动备份当前配置,改错了也能退回去。
老用户三步开始省
升级到 0.4 版之后,打开 Hermes 管理页,点右上角的 ⚡ 图标,选「推荐」档,这一步就完成了。接下来一周不用管它,等看板上「压缩次数」开始有数字,再决定要不要往两边挪——拿不准的时候,从推荐档起步就行。
顺手提一句,如果你正在 macOS 上搭本地 AI 助手,可以看看仙踪问道·爱马仕助手(Hermes Assistant)。它把 Hermes Agent 的安装、Python 环境和国内网络加速做成了一键流程,图形界面里就能切模型、切档位、看用量,不用碰命令行;内置的 Pi 智能助手能用自然语言排查环境问题,配套的桌面 App 和 Web 监控面板可以把任务状态和资源占用一起看住。
省 token 这件事没什么玄学,把看不见的账单变成看得见的数字,才谈得上优化。如果这篇对你有用,欢迎关注「仙踪·智能工作生活」,这里每周分享 AI 工具、本地部署和效率实操。你现在的 AI 助手开了压缩吗?一周的缓存读取量大概是多少?评论区聊聊你的数字,我挑几个典型场景,下次专门拆一档怎么选。